
Les détecteurs de textes générés par intelligence artificielle se sont multipliés depuis la diffusion massive des modèles de langage. Universités, rédactions, recruteurs : les usages se diversifient, et avec eux les malentendus sur ce que ces outils mesurent réellement.
Une étude menée par des chercheurs de Stanford et publiée dans la revue Patterns a montré que sept détecteurs testés sur 91 essais TOEFL rédigés par des anglophones non natifs ont classé à tort une grande partie de ces textes comme générés par IA.
La simplicité lexicale et syntaxique de ces rédactions a suffi à tromper les algorithmes. Ce constat pose une question directe : que vaut un score de détection, et comment l’utiliser sans nuire à la personne évaluée ?
Biais linguistique des détecteurs IA : un angle mort documenté
Les détecteurs fonctionnent en analysant des régularités statistiques dans le texte soumis. Perplexité faible, variation lexicale réduite, structures syntaxiques prévisibles : ces signaux orientent le verdict vers une origine artificielle.
Le problème survient quand un texte humain partage ces mêmes caractéristiques. C’est précisément ce que l’étude de Stanford a mis en évidence avec les essais TOEFL : des rédacteurs réels, écrivant dans une langue apprise, produisent naturellement des phrases courtes, un vocabulaire restreint et des constructions répétitives. Les détecteurs y voient les marqueurs d’un modèle de langage.
Ce biais ne se limite pas aux apprenants de langues. Des journalistes professionnels dont le style est structuré et factuel ont également été signalés par certains outils. Un texte clair, bien organisé, sans digressions, peut déclencher un faux positif, non parce qu’il est artificiel, mais parce qu’il ressemble à ce que produirait une machine entraînée à générer du texte fluide.
Plusieurs plateformes proposent de soumettre un texte pour obtenir un score de probabilité, comme le fait un chatgpt detector tel que ZeroGPT, qui analyse la structure et les patterns du texte soumis. Ces outils fournissent un indice, pas un verdict.
Score de détection IA : ce qu’un pourcentage ne dit pas
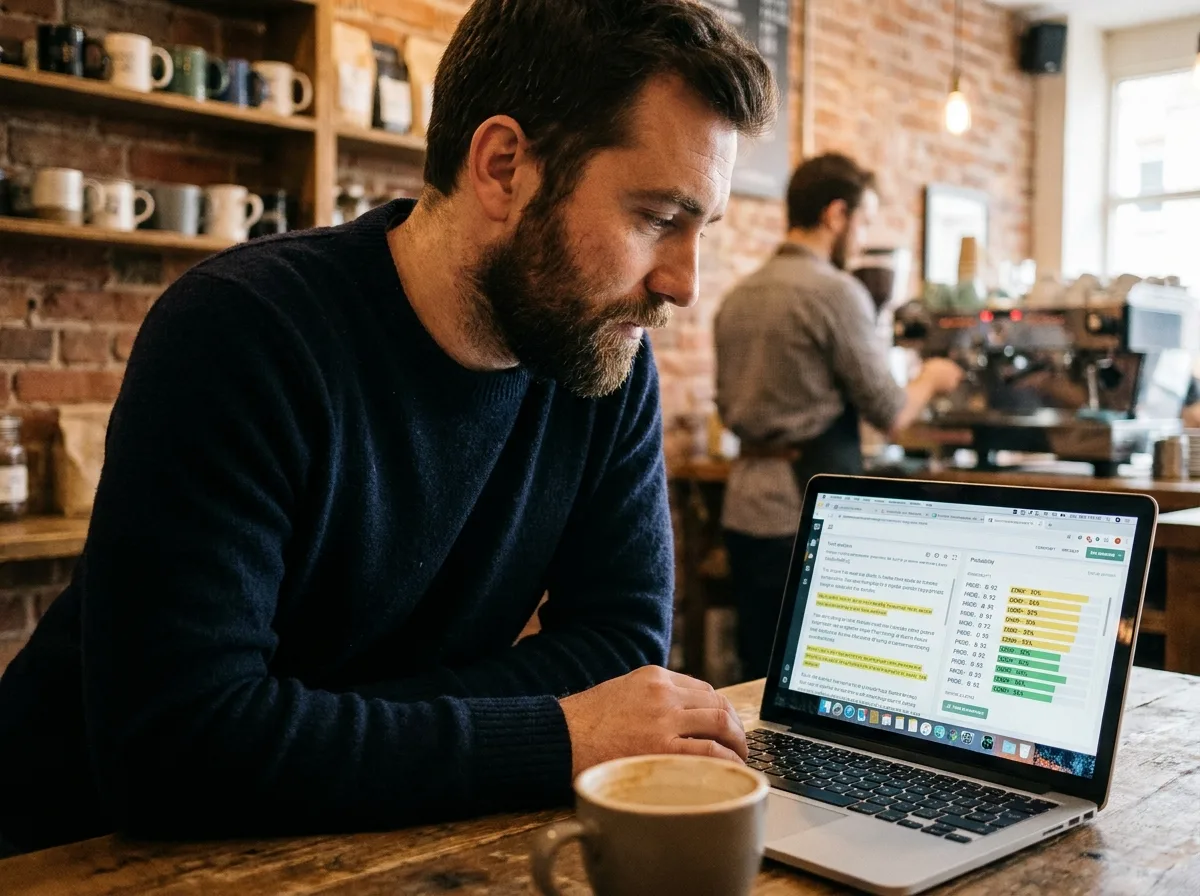
Un score affiché de 85 % ne signifie pas que le texte a 85 % de chances d’avoir été écrit par une IA. Il indique que le modèle de détection, selon ses critères internes, attribue cette probabilité au texte analysé. La distinction est fondamentale.
Le seuil choisi par l’outil détermine le taux d’erreurs concrètes. Un détecteur réglé pour être très sensible attrapera davantage de textes IA, mais accusera aussi plus de textes humains. Un seuil plus conservateur laissera passer des contenus générés, mais réduira les fausses accusations. Les plateformes communiquent rarement sur le seuil retenu ni sur le taux de faux positifs qui en découle.
Un score de classement global (souvent présenté comme une mesure de précision) peut masquer ces arbitrages. Si un outil affiche une précision globale élevée mais génère un taux de fausses accusations significatif au seuil qu’il utilise par défaut, la mesure globale de performance devient trompeuse pour l’utilisateur final.
Combiner plusieurs détecteurs ne garantit rien
Une idée répandue consiste à soumettre un texte à plusieurs outils pour confirmer un résultat. L’intuition semble logique : si trois détecteurs convergent, le diagnostic serait plus fiable.
Les données disponibles contredisent cette hypothèse. Plusieurs outils partagent des erreurs sur les mêmes types de textes, notamment les textes humains clairs et structurés. Les détecteurs réagissent souvent aux mêmes caractéristiques stylistiques, ce qui signifie que leurs erreurs ne sont pas indépendantes. Additionner des résultats corrélés ne produit pas une confirmation plus solide.
Procédure équitable de vérification quand le score est contesté
Réduire la vérification d’un texte à un score automatique revient à confier un jugement à un outil qui ne connaît ni le contexte de rédaction, ni le parcours de l’auteur, ni les contraintes du sujet. Lorsqu’un score de détection IA est contesté, en milieu universitaire ou professionnel, la réponse ne peut pas être uniquement technique.
Une procédure de vérification équitable repose sur plusieurs éléments concrets :
- L’historique des versions du document, lorsqu’il existe (brouillons successifs, historique Google Docs, fichiers intermédiaires), permet de retracer le processus d’écriture. Un texte rédigé progressivement laisse des traces qu’un copier-coller depuis un chatbot ne produit pas.
- Un échange direct avec l’auteur, portant sur les choix de formulation, les sources consultées et la démarche argumentative, révèle rapidement si la personne maîtrise le contenu qu’elle a signé.
- La prise en compte du profil linguistique de l’auteur est nécessaire : un étudiant international ou un rédacteur écrivant dans une langue seconde ne peut pas être évalué avec les mêmes attentes stylistiques qu’un locuteur natif.
- Le score du détecteur est utilisé comme un signal parmi d’autres, jamais comme preuve unique. Il déclenche une vérification, il ne la conclut pas.
Aucun détecteur ne peut identifier l’auteur d’un texte. Il mesure une proximité statistique avec des patterns de génération automatique, ce qui est fondamentalement différent d’une attribution d’auteur.
Cadre réglementaire européen : marquage à la source et obligations de transparence
Le règlement européen sur l’IA aborde la question sous un angle distinct de la détection a posteriori. L’article 50 prévoit, pour les fournisseurs concernés, le marquage des contenus générés ou manipulés dans un format lisible par machine et leur détectabilité. L’idée est d’agir en amont : plutôt que de deviner si un texte est artificiel après sa publication, le rendre identifiable dès sa création.
Ce même article prévoit une obligation de divulgation pour certains textes publiés afin d’informer le public sur des sujets d’intérêt public. Une exception existe lorsque le texte a fait l’objet d’un contrôle éditorial humain et qu’une personne physique ou morale en assume la responsabilité éditoriale.
L’adhésion au code européen de bonnes pratiques ne constitue pas une preuve concluante de conformité. La documentation juridique de la Commission indique que ce code peut aider à démontrer le respect des obligations de transparence, sans pour autant valoir certification. La nuance est significative pour les organisations qui souhaiteraient s’appuyer uniquement sur cette adhésion.
Le marquage à la source (parfois appelé filigrane ou watermarking) reste techniquement complexe à généraliser. Il suppose que tous les fournisseurs de modèles de langage l’implémentent, que le marquage résiste aux modifications du texte, et que des outils de lecture de ce marquage soient accessibles. Ces conditions ne sont pas encore réunies de manière uniforme.
La détection des textes générés par IA reste un outil imparfait, utile comme signal d’alerte mais inadapté comme juge final. Le score affiché par un détecteur ne remplace ni l’analyse humaine, ni le dialogue avec l’auteur, ni la traçabilité du processus d’écriture. Toute organisation qui s’appuie sur ces outils gagne à formaliser une procédure de vérification qui va au-delà du pourcentage affiché à l’écran.